사내 AI 에이전트의 장기 기억: 온톨로지로 담당자와 자료를 연결하기
사내 AI 에이전트 인포미는 회사를 명사(사람·제품·기능·문서·회의)와 동사(맡는다·속한다·설명한다·정했다)로 적어 두고, 로그인 문의 하나가 담당자·문서·지난 결정으로 갈라지는 길을 그대로 따라가요. git 안의 Markdown 파일과 한 줄짜리 인덱스로 필요한 기억만 읽고, 쓰기 훅과 정리 타이머로 유지하는 방식을 소개해요.
2026-09-10

TL;DR
- "로그인이 안 된다는 문의가 왔는데 누구한테 물어봐요?"에 답하려면 담당자 이름 하나가 아니라, 그 기능을 누가 맡고 어떤 문서가 설명하고 지난 회의에서 뭘 정했는지가 한 줄로 이어져 있어야 해요.
- 인포미는 그 연결을 온톨로지, 즉 명사(사람·제품·기능·문서·회의)와 동사(맡는다·속한다·설명한다·정했다)로 적어 두고, 한 줄짜리 인덱스로 필요한 기억 파일만 골라 읽습니다.
- 기억은 git 안의 Markdown 파일이에요. 쓰기는 쓰기 훅과 파일링 규칙을 지나 커밋되고, 밤마다 distiller, 주말마다 curator가 정리 제안을 만들어 사람이 적용합니다.
질문 하나가 사람·문서·결정을 한 번에 건드린다
마인드로직에서 쓰는 사내 AI 에이전트 인포미는 회사 자료를 찾고 업무를 도와요. 이 글 전체에서 예시 하나만 쓸게요. 고객지원 채널에 이런 문의가 올라왔다고 해 봅시다.
"학교 계정으로 로그인이 안 된다는 문의가 들어왔어요. 누가 봐야 하고, 뭘 먼저 확인하죠?"
사람이 이 질문에 답하려면 머릿속에서 세 가지를 잇습니다. 로그인 기능은 누가 맡는지(사람), 로그인 연동 가이드가 어디 있는지(문서), 지난달 장애 때 무엇을 먼저 확인하기로 했는지(결정). 셋은 각각 Slack 프로필, Google Drive, Notion 회의록에 흩어져 있어요. 에이전트가 답하려면 이 세 조각이 서로 이어져 있어야 합니다.
처음에는 이것을 전부 시스템 프롬프트에 적었어요. "로그인은 A가 담당", "연동 가이드는 이 폴더", "장애 시 먼저 확인할 것" 같은 줄을 한 문서에 쌓아 두면 되지 않을까 싶었죠. 문서가 길어질수록 필요한 줄을 놓쳤고, 담당자가 바뀌었을 때 한 줄만 고쳐져 다른 줄과 어긋났어요. 어느 줄이 아직 유효한지 확인하기도 어려웠고요. 그래서 사실을 어떻게 적을지부터 다시 잡았습니다.
명사와 동사로 회사를 적는다
온톨로지는 회사에 있는 것들(명사)과 그 사이의 관계(동사)를 정해 둔 모델이에요. 어렵게 들리지만 실제로 적는 것은 이런 문장들입니다.
- 정빈 맡는다 로그인 기능
- 로그인 기능 속한다 제품 A
- 연동 가이드 설명한다 로그인 기능
- 9월 3일 회의 정했다 "로그인 오류는 학교 쪽 인증 서버 상태부터 확인"
명사는 사람, 팀, 제품, 기능, 문서, 회의, 결정 정도예요. 동사는 맡는다, 속한다, 설명한다, 정했다 네 개로 거의 다 됩니다. 이렇게 적어 두면 위의 문의는 세 갈래 질문으로 풀리고, 각 갈래가 동사 하나를 따라가요.
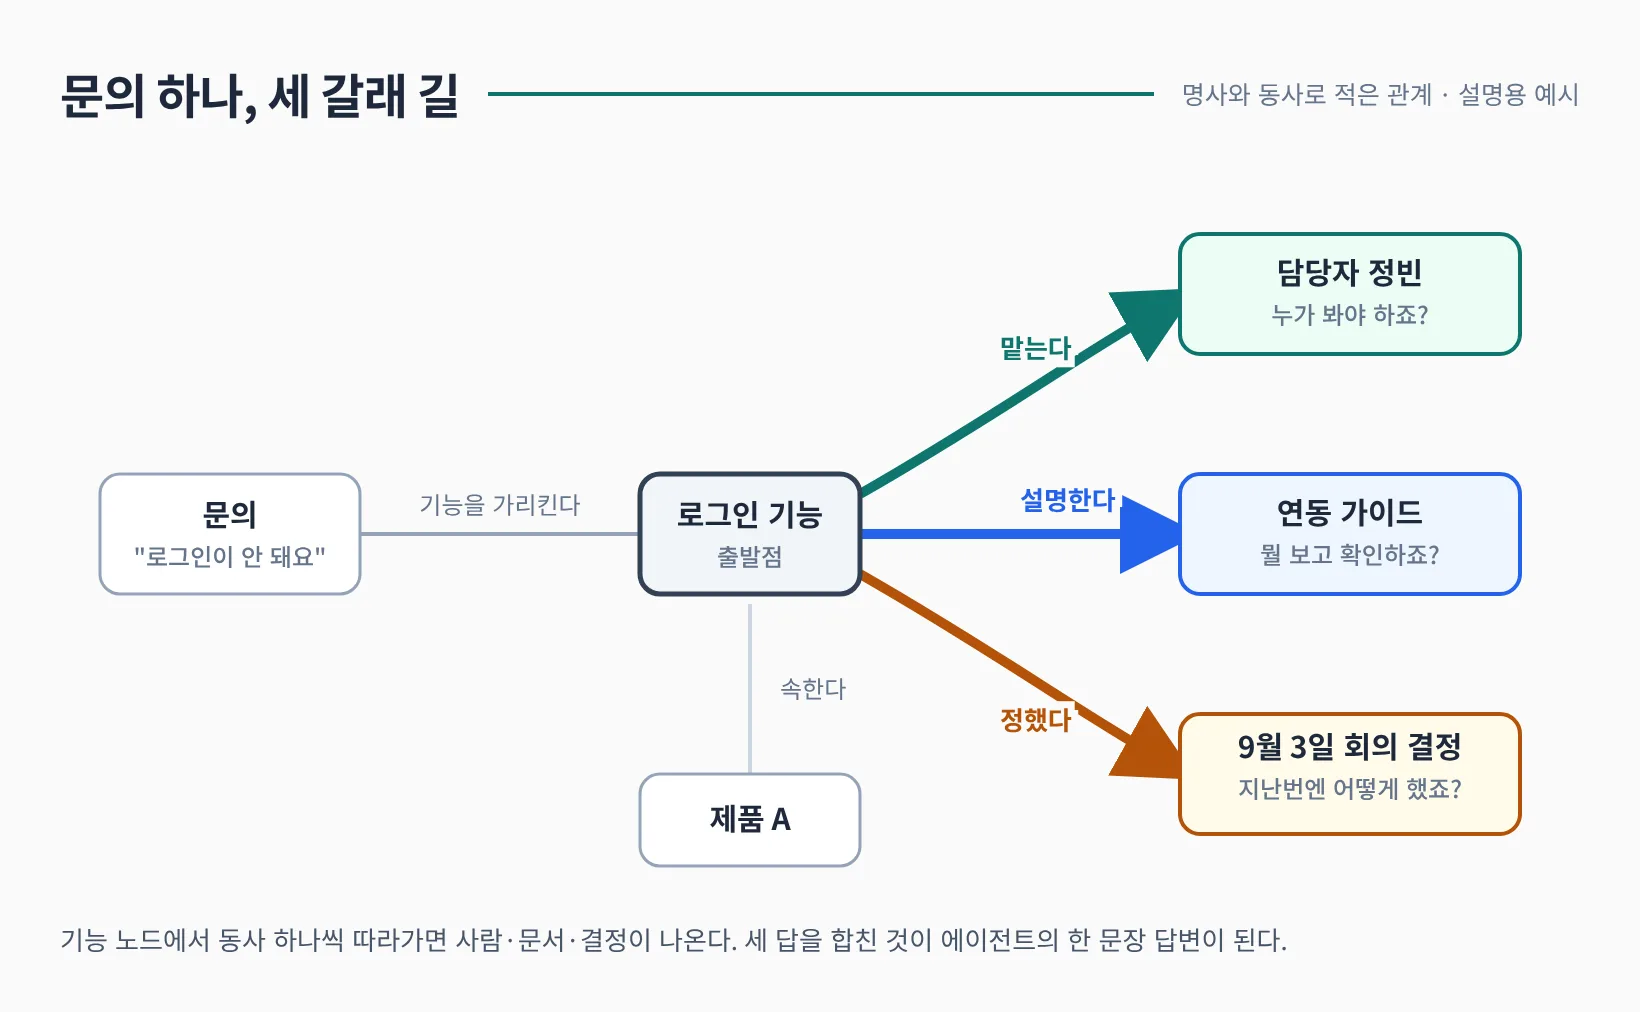
문의 하나가 걷는 세 갈래 길. "누가 봐야 하죠?"는 맡는다를, "뭘 보고 확인하죠?"는 설명한다를, "지난번엔 어떻게 했죠?"는 정했다를 따라가요.
"누가 봐야 하죠?"는 로그인 기능에서 맡는다를 거꾸로 따라가면 정빈이 나와요. "뭘 보고 확인하죠?"는 설명한다를 따라가면 연동 가이드가, "지난번엔 어떻게 했죠?"는 정했다를 따라가면 9월 3일 회의 결정이 나옵니다. 세 답이 같은 기능 노드에서 출발하니까, 에이전트는 "정빈님이 담당이고, 연동 가이드는 여기, 지난달에 학교 인증 서버 상태부터 확인하기로 했어요"를 한 번에 조립할 수 있어요.
이 모델은 특정 데이터베이스나 검색 기술을 가리키지 않아요. 저희는 그래프 DB를 따로 두지 않고, 이 문장들을 Markdown 파일과 그 파일의 frontmatter에 적습니다. 담당 관계는 라우팅 기억 파일에, 문서 위치는 해당 주제의 기억 파일에, 결정은 회의록 다이제스트에 있고, 인포미가 질문을 받으면 세 곳을 잇는 거예요. 어떤 저장소에 둘지, 무엇을 먼저 찾을지, 변경을 언제 반영할지는 모델과 별도의 결정입니다.
동사 중에 맡는다를 따로 적는 일이 특히 중요했어요. 답을 찾아도 엉뚱한 사람에게 일을 넘기면 그 사람이 다시 담당자를 찾아야 했거든요. 그래서 누가 확인해야 하는지도 답의 일부로 다루게 됐어요. 같은 파일에 "로그인 문의는 정빈, 자동응답 오답은 건영, 계약은 사업팀" 같은 라우팅과, 사람을 태그할 때 어떤 형식이어야 알림이 가는지 같은 규칙도 들어 있습니다.
사람이 찾을 수 있는 기록부터
온톨로지를 적는 것만큼 회사가 평소에 기록을 어떻게 남기느냐도 중요했어요. 에이전트는 회사가 이미 써 둔 것을 읽어요. 위 예시의 정했다 관계는 9월 3일 회의록이 Notion에 남아 있어야 성립합니다. 회의에서 정한 내용을 남기지 않으면 "지난번엔 어떻게 했죠"에 답할 근거가 없죠.
회의록을 Notion 팀별 DB에 남기고, 회의실 녹음은 사내 회의 녹음기가 전사해 두고, 함께 알아야 할 결정은 공유 채널과 문서에 정리하는 습관이 입력의 바탕이 됐어요. 인포미는 매주 금요일 두 소스를 합쳐 주간 다이제스트 문서를 만들고, "지난주에 뭐 정했지"는 이 다이제스트부터 검색합니다. 개인 DM에만 남은 내용은 회사 공통의 지식이 되지 못하니까요.
문서가 남아 있어도 낡았거나 같은 주제가 여러 곳에 갈라져 있으면 확인이 어려워요. 예전 절차를 현재 절차로 받아들이지 않도록 중복과 오래된 내용을 정리하는 작업도 함께 뒀어요. 사람이 읽기 좋게 남긴 기록이 에이전트에게도 쓸 만한 근거가 됐습니다.
교정을 다음 대화에 남기는 방법
온톨로지가 처음부터 완전할 수는 없어요. 로그인 담당이 정빈에서 다른 사람으로 바뀌었는데 인포미가 여전히 정빈을 태그했다면, 누군가 "이제 그거 제가 봐요"라고 고쳐 주겠죠. 그 교정은 두 종류 중 하나예요. 맡는다 문장의 값이 틀린 것이거나, "어떤 종류의 문의를 누구에게 넘길지"라는 기준 자체를 보완해야 하는 것.
인포미는 이 둘을 frontmatter의 type 필드로 구분해요. 값이 틀린 것은 type: reference 파일을 고치고, 여러 대화에 적용할 기준은 type: feedback으로 남깁니다. feedback 파일의 인덱스 줄은 매 세션 프롬프트에 규칙으로 실리고, reference는 필요할 때만 읽혀요. 그래서 이 필드를 잘못 붙이면 규칙이 사실로 분류돼 한 번도 발동하지 않습니다. 항상 읽히는 단일 규칙 파일에 들어갈 변경은 사람이 PR로 검토해요.
교정을 저장해도 필요한 순간에 그 파일을 읽어야 효과가 나고, 담당이 다시 바뀌면 내용도 다시 고쳐야 해요. 저희가 바꾼 것은 교정이 대화 밖의 파일과 git 이력에 남아 다음 판단의 근거가 되도록 한 점입니다.
사람마다 다른 답변 기준
같은 로그인 문의라도 답을 받는 사람에 따라 원하는 모양이 달라요. 어떤 분은 "정빈님 태그했어요" 한 줄이면 되고, 어떤 분은 연동 가이드 링크와 지난 장애 회의록까지 같이 받고 싶어 하죠. 누군가는 숫자 뒤에 출처를 붙이라고 하고, 누군가는 문서를 만들 때 한국어 윤문 검수를 거치게 해요. 이런 선호는 회사 전체에 적용되는 사실과 나누어 다뤄요.
사람마다 개인 기억 파일 하나를 두고, 대화가 시작될 때 질문한 사람의 파일만 전문으로 프롬프트에 넣어요. 다른 사람의 선호를 매번 함께 넣을 필요는 없으니까요. 무엇을 기본으로 읽는지는 편의의 문제이고, 누가 어느 파일에 접근할 수 있는지는 권한의 문제라서 둘은 따로 정합니다. 다른 구성원의 개인 기억 파일과 업로드 디렉터리는 그 사람이 스레드에 있을 때만 읽어요. 권한 쪽 이야기는 2편에서 이어져요.
무엇을 남기고 언제 읽을까?
여러 사람이 여러 채널에서 쓰다 보면 기억 후보도 계속 생겨요. 한 스레드에서 배운 것을 그 스레드만 기억해서는 부족하지만, 모든 대화 내용을 장기 기억에 넣을 수도 없죠.
질문한 사람의 선호는 개인 기억에, 회사 공통의 사실은 공용 기억에, 순서가 있는 작업 절차는 스킬 문서에 둬요. 그날 마친 작업의 진행 상황이나 임시 파일 경로처럼 금방 낡을 내용은 장기 기억으로 남기지 않고, 지난 작업의 맥락이 필요하면 대화 로그를 검색합니다. 이미 같은 주제의 파일이 있다면 사본을 늘리기보다 기존 파일을 고쳐요. 새 공용 파일은 4 KB를 넘을 수 없고 같은 접두사의 형제 파일도 5개까지라, 6번째를 만들려 하면 파일링 규칙이 "어느 파일에 합쳐라"까지 알려줍니다.
이 구조를 잡을 때 Nous Research의 Hermes Agent를 참고했어요. 사용자의 선호와 배운 내용을 세션을 넘어 기억하고, 작업 절차를 스킬로 만들어 재사용하는 개인 에이전트예요. 사실을 담는 메모리와 절차를 담는 스킬을 구분하는 발상을 가져왔고, 회사에서 함께 쓰려면 여기에 담당 관계와 공용·개인 정보의 구분, 변경을 검토하는 기준이 더 필요했습니다.
저장한 파일을 매 대화에 전부 넣으면 처음의 큰 프롬프트로 돌아가요. 그래서 파일마다 언제 읽어야 하는지 한 줄로 적은 인덱스 파일을 두고, 세션은 인덱스만 받은 채 요청에 맞는 파일을 열어요. 도서관에서 책을 전부 펴 놓는 대신 목록 카드를 먼저 보고 서가로 가는 것과 같아요. 로그인 문의가 들어오면 인덱스에서 "로그인·인증 문의 라우팅"이라고 적힌 줄을 보고 그 파일 하나만 여는 식입니다. 인덱스는 약 20 KB, 항상 실리는 것 전부를 합쳐도 112 KB 안에 들도록 테스트가 잡고 있어요.
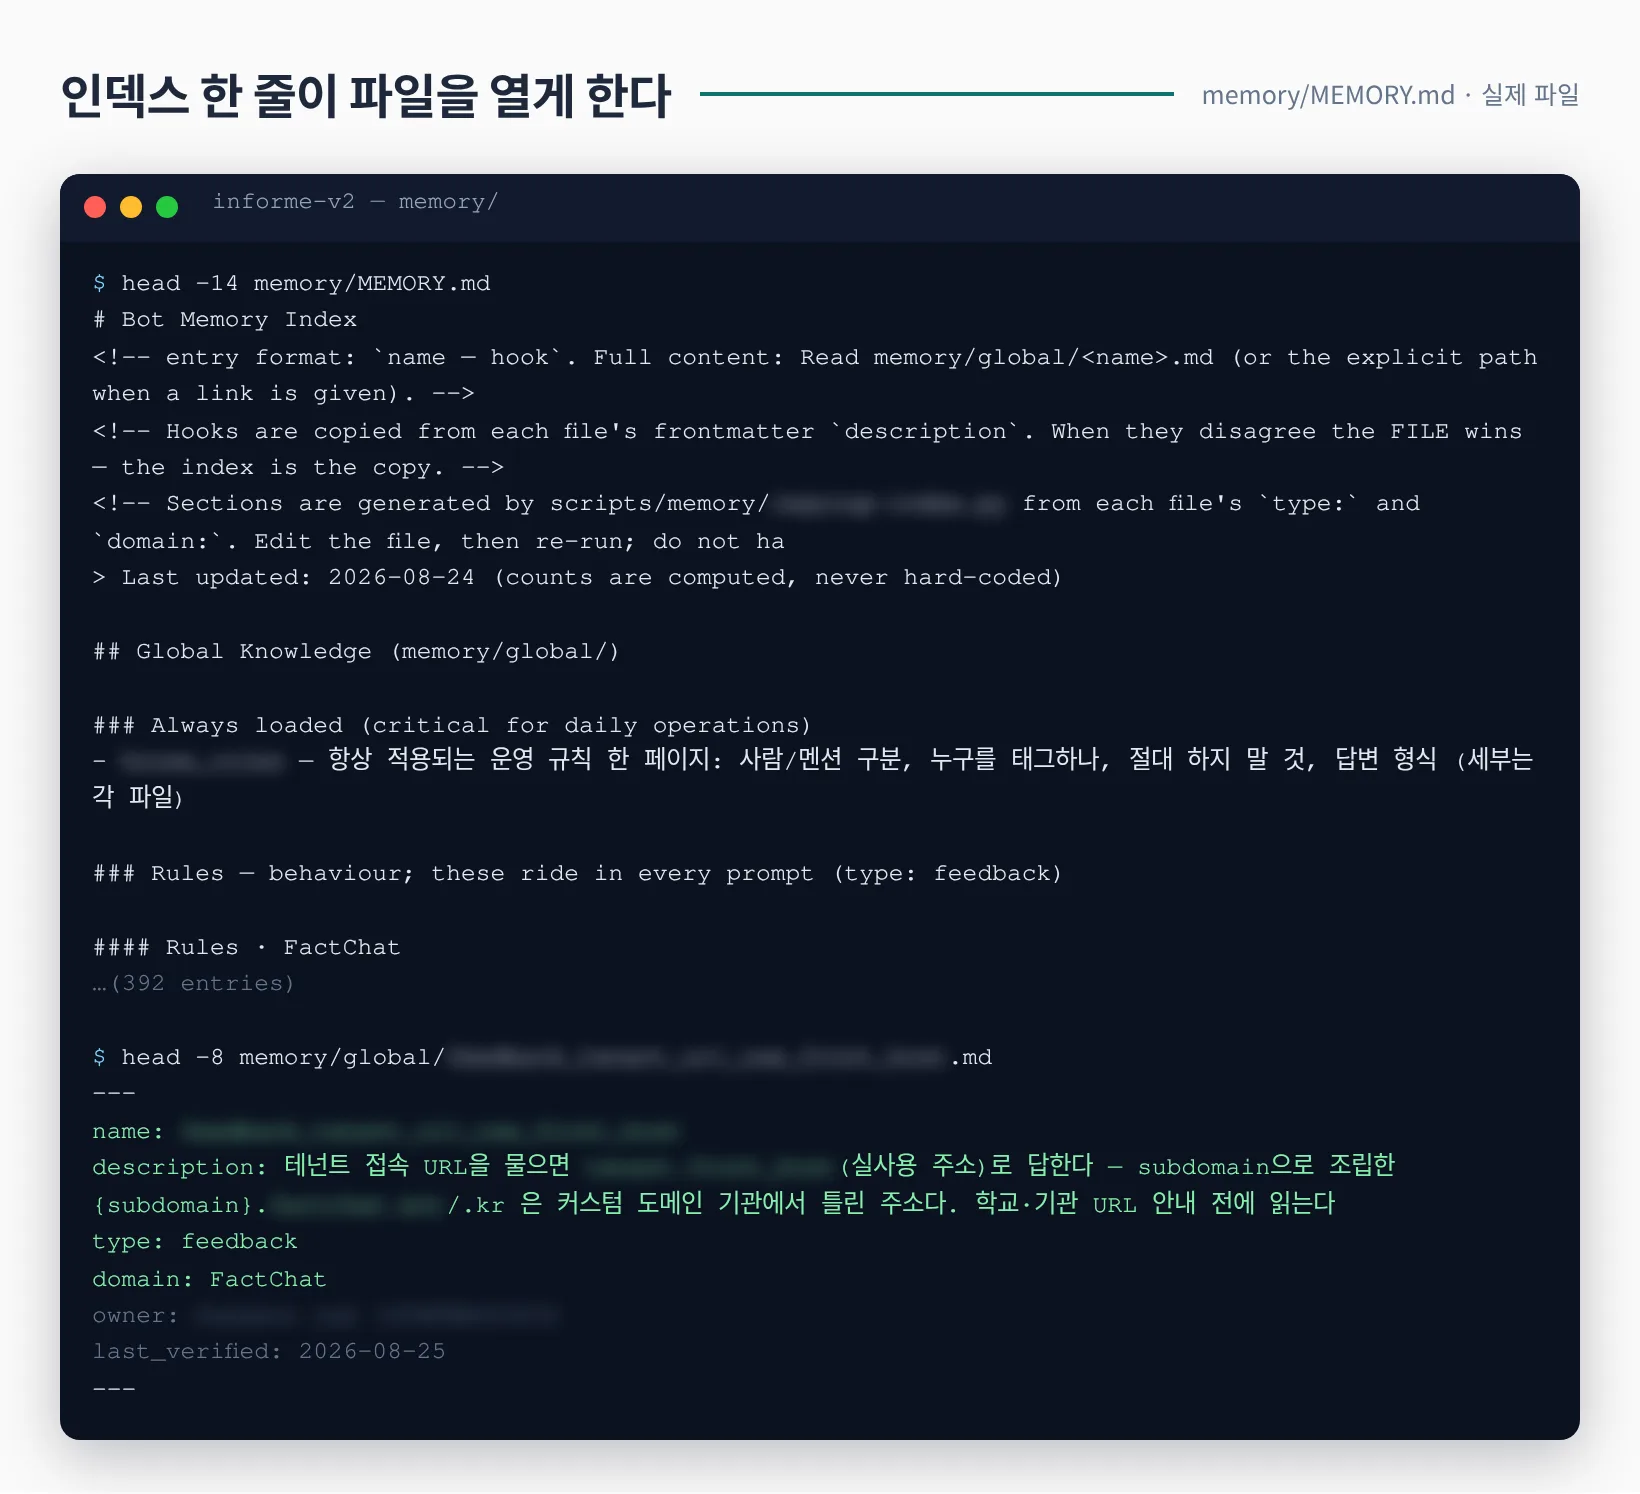
실제 인덱스 앞부분과 기억 파일 하나의 frontmatter. description이 곧 인덱스 줄이라, 이 한 줄이 파일을 열게 하는 검색 표면이에요.
회사 기억에는 이 인덱스와 파일 읽기, 키워드 검색을 중심으로 쓰고, 외부 문서를 찾는 데는 문장의 뜻이 비슷한 것을 찾아 주는 벡터 검색도 사용해요. 인덱스가 있으면 어떤 기억을 열었는지가 대화 로그에 그대로 드러나서 사람이 확인하기 좋다는 점이 이 선택의 이유였습니다.
기록도 회사와 함께 바뀐다
담당자는 바뀌고 문서는 옮겨지고 결정은 뒤집혀요. 처음에는 정리 작업이 낸 제안을 사람이 검토해서 반영했는데, 바쁜 시기에는 제안이 쌓이기만 했어요. 기억을 만드는 일과 유지하는 일을 따로 보게 된 계기였죠.
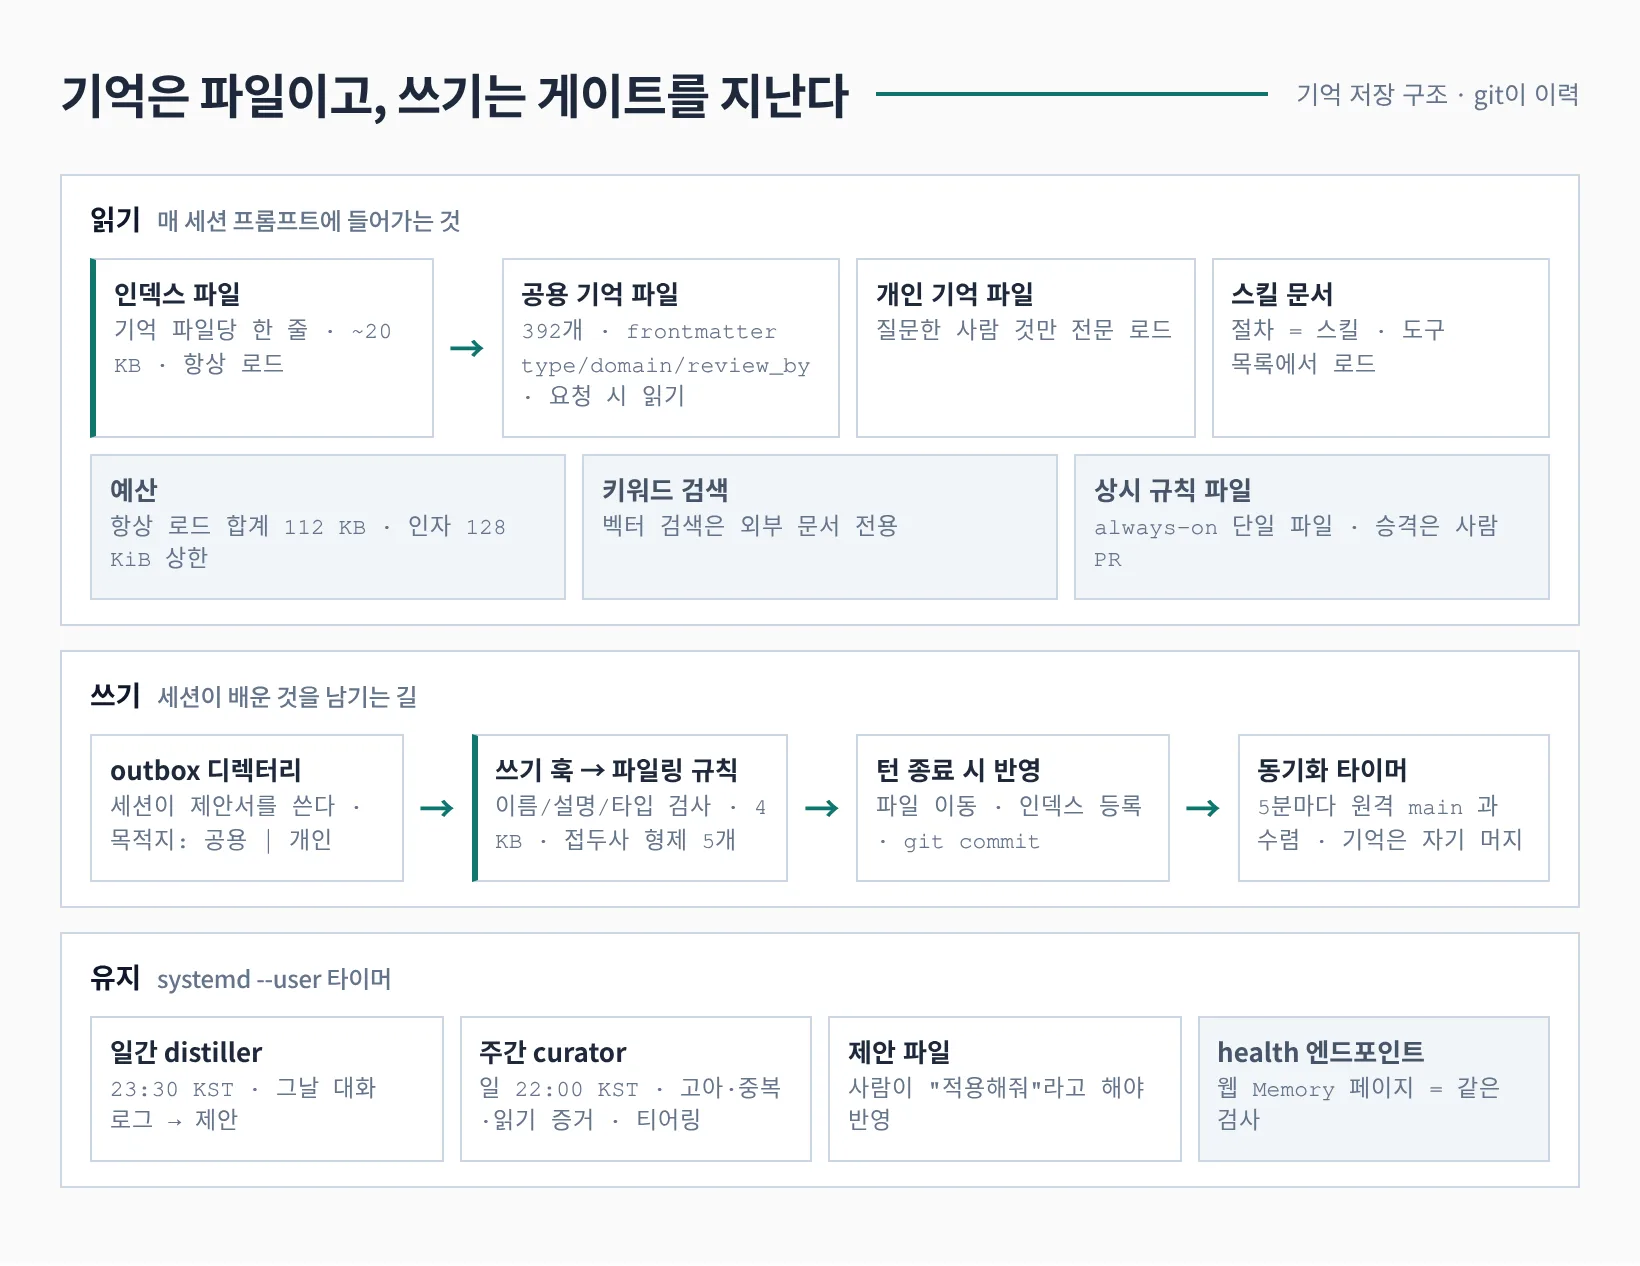
기억의 세 경로. 읽기는 인덱스에서 파일로, 쓰기는 outbox에서 훅과 파일링 규칙을 지나 커밋으로, 유지는 systemd 타이머가 만든 제안을 사람이 적용하는 흐름이에요.
지금은 세션이 배운 것을 outbox 디렉터리에 제안서로 쓰고, 파일을 쓰는 순간 쓰기 훅이 파일링 규칙으로 이름·설명·타입·크기를 검사해 결과를 그 세션에 바로 알려줍니다. 턴이 끝나면 통과한 제안이 기억 저장소로 옮겨져 인덱스에 등록되고 git 커밋돼요. 밤 23:30에는 distiller가 그날 대화 로그에서 반복된 교정을 모아 제안을 만들고, 일요일 22:00에는 curator가 고아 파일·중복·읽힌 적 없는 파일을 점검해 제안 파일에 적습니다. 두 작업의 제안은 사람이 "적용해줘"라고 해야 반영돼요. 회의에서 "로그인 담당 변경"이 나오면 주간 다이제스트가 맡는다 문장을 고칠 근거가 됩니다.
항상 적용되는 규칙이나 에이전트의 기본 지침처럼 영향이 큰 변경은 사람이 검토해요. 사실을 최신 기록과 맞추는 일과 공통 행동 기준을 바꾸는 일은 영향 범위가 다르기 때문이에요. 관계를 잘 적어 두는 것에 더해, 그 관계가 달라졌을 때 수정하는 운영이 필요했습니다.
정리하면
인포미의 장기 기억은 "누가 봐야 하고, 뭘 보고, 지난번엔 어떻게 했는지"를 한 번에 찾기 위한 구조예요. 온톨로지가 명사와 동사로 그 관계를 정의하고, Markdown 파일과 인덱스, 훅과 타이머로 이루어진 저장·검색·갱신 방식이 일상 업무에서 그 관계를 쓰게 해 줍니다.
한 번 적은 내용을 계속 맞는 것으로 두지 않고, 대화에서 받은 교정과 새 기록을 git 이력이 남는 파일에 반영해요. 필요한 기억을 골라 읽는 과정까지 갖춰야 담당자 이름과 문서 위치가 로그인 문의 같은 실제 질문에 대한 답으로 이어졌어요.
이 기억을 바탕으로 에이전트가 무엇을 해도 되는지는 2편 권한 설계에서, 어디에서 부르는지는 3편 슬랙·웹·CLI에서 이어져요. 개인 에이전트를 회사 업무로 확장하는 배경은 Hermes와 OpenClaw를 다룬 글에도 있습니다.