새벽 3시, AI가 당신을 기억하는 법
매번 같은 말을 반복하지 않아도 되는 AI — FactChat User Memory 기능을 어떻게 만들었는지 이야기해요.
2026-03-04
TL;DR
FactChat에 User Memory 기능을 도입했어요. 유저가 직접 관리하는 메모와 AI가 자동으로 만드는 프로필, 두 가지 저장소를 조합해서 "나를 아는 AI"를 구현했어요. 매일 새벽 3시, 자체 LLM인 SAIT 2 Pro가 조용히 돌아가면서 유저 프로필을 업데이트하는 게 그 비밀이에요.
"아까 말했잖아" — AI 챗봇의 가장 큰 불만
"저 아까 마케팅팀이라고 했잖아요."
AI 챗봇을 쓰다 보면 이런 경험 있을 거예요. 분명 5분 전에 내 상황을 설명했는데, 새 대화를 시작하면 또 처음부터 다시 설명해야 하는 거죠. 솔직히 말하면, 이게 AI 챗봇에서 가장 답답한 순간이에요.
동료한테 "나 이번 달 목표가 뭐냐면..." 하고 한 번 말했으면, 다음에 다시 물어볼 때 그 맥락을 기억하잖아요. 그런데 AI는 매번 백지 상태에서 시작해요. 대화 세션이 바뀌면 이전에 나눈 이야기가 전부 사라지니까요.
단순히 대화 기록을 길게 이어붙이는 건 답이 아니었어요. 토큰 비용도 문제지만, 정말 중요한 건 "이 사람이 누구인지"를 구조화해서 기억하는 거였거든요. 그래서 User Memory를 만들었어요.
기억을 두 곳에 나눠 담다
User Memory를 설계할 때 가장 먼저 결정한 건, 기억을 두 종류로 나누자는 거였어요.
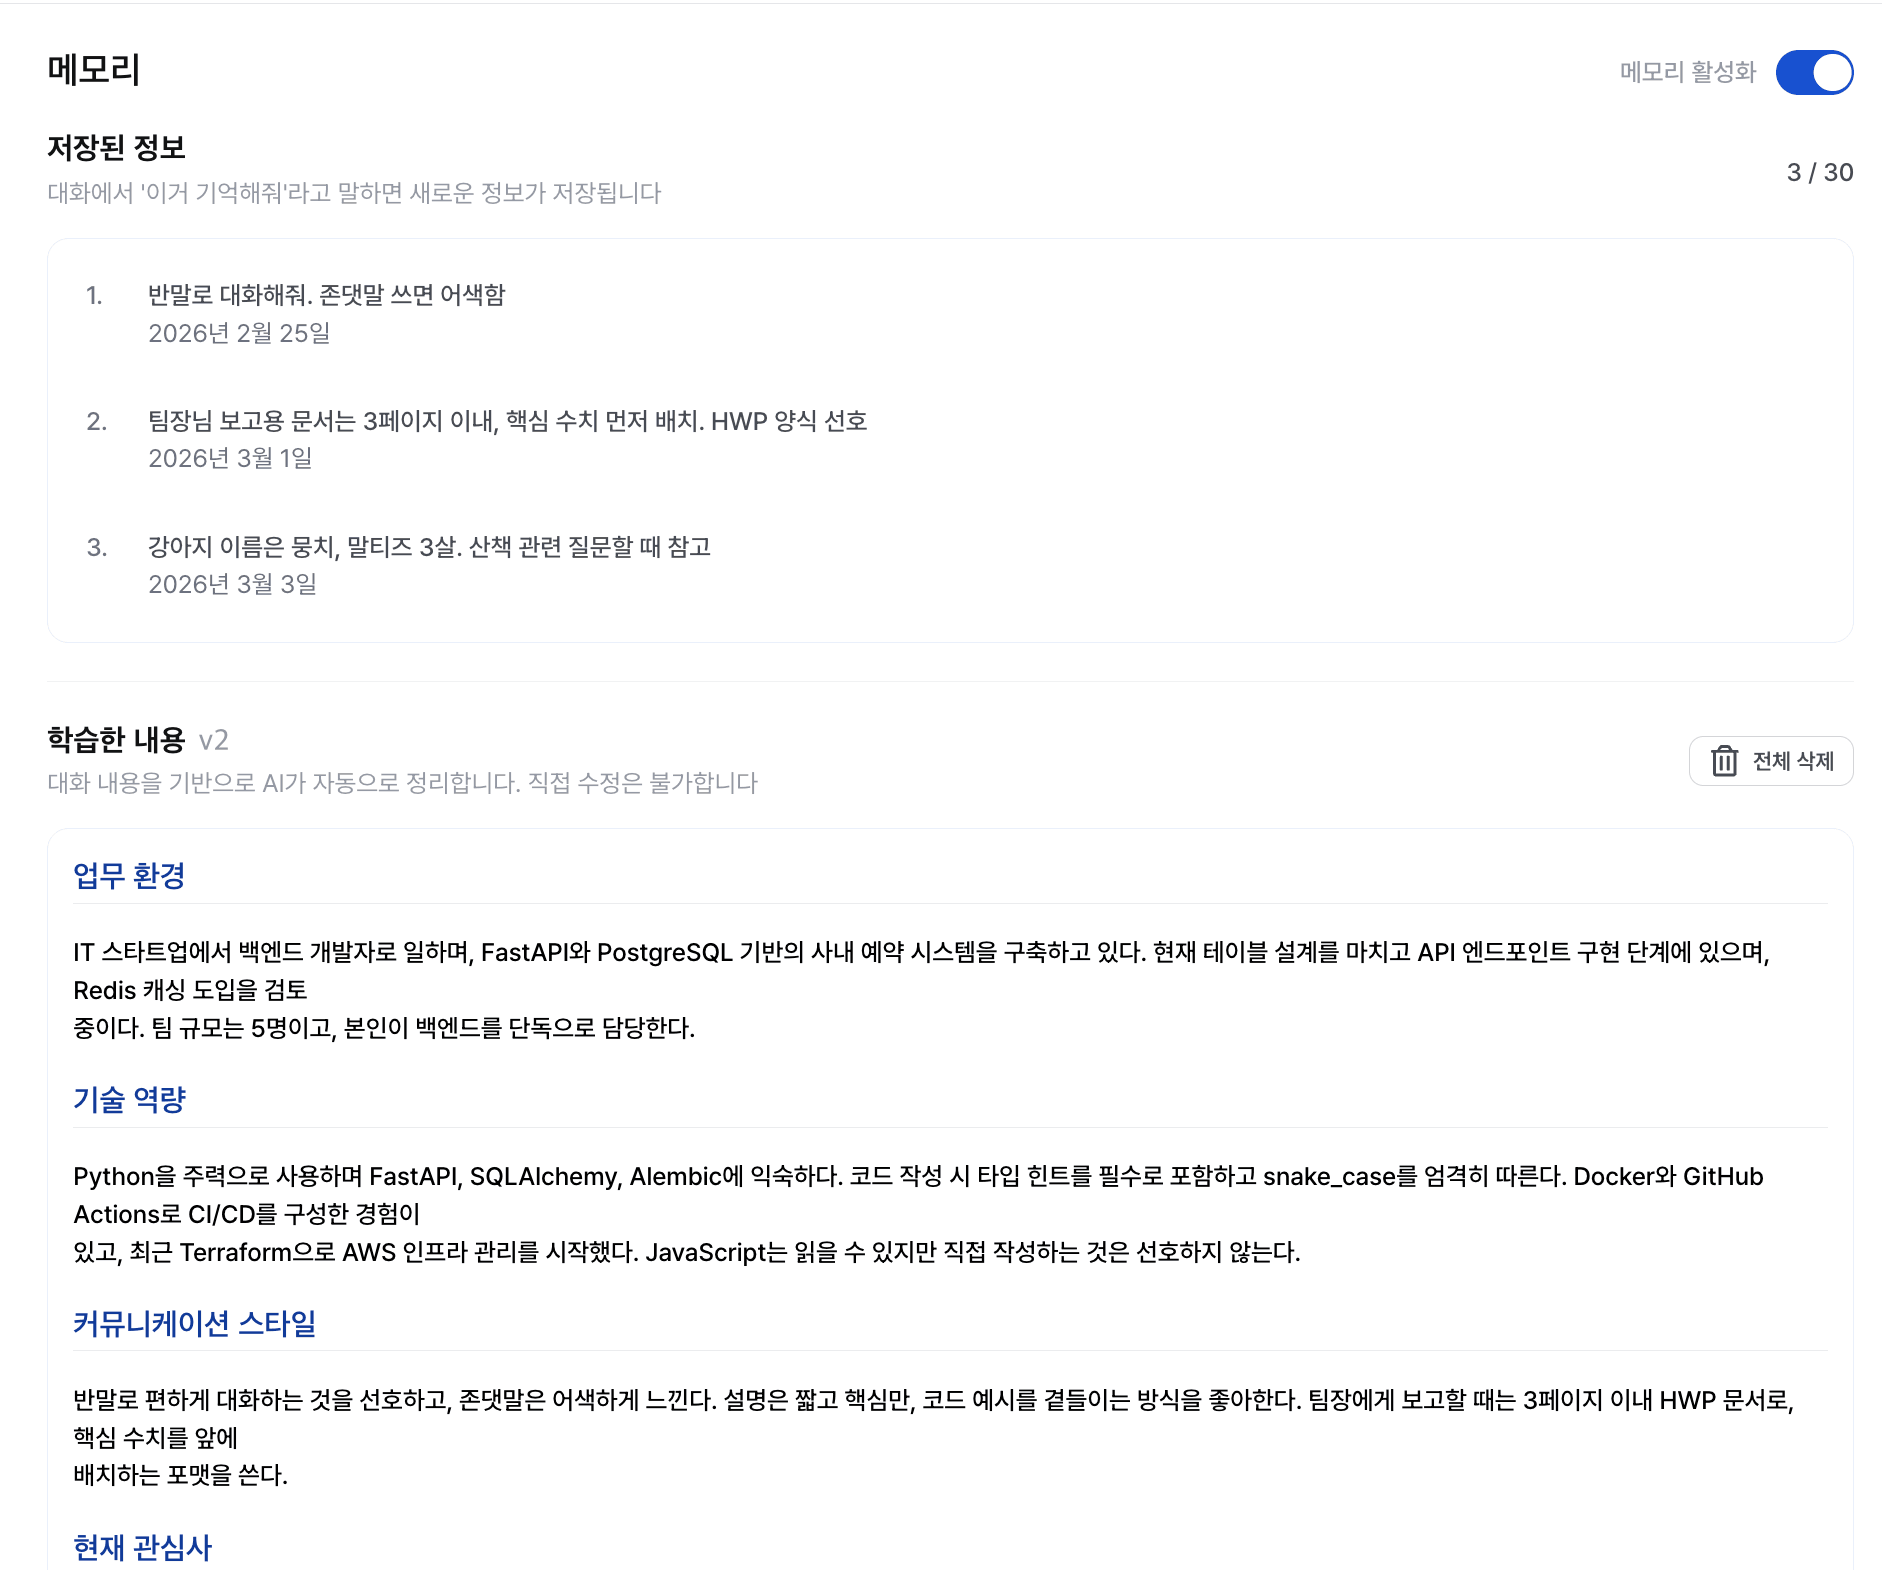
저장된 정보: 유저가 직접 관리하는 메모
첫 번째는 유저가 직접 작성하고 관리하는 메모예요. 최대 30개까지, 각 항목 200자 이내로 등록할 수 있어요. 메모리가 너무 길어지면 오히려 AI가 혼란스러워지더라고요. 짧고 명확한 정보가 훨씬 효과적이었어요.
실제로 유저들이 어떤 걸 저장하는지 보면 정말 다양해요:
"이렇게 말해줘" — 소통 스타일
- "편하게 반말로 대화해줘"
- "결론부터 말해주고, 부연 설명은 뒤에 붙여줘"
- "전문 용어 쓰지 말고 쉽게 풀어서 설명해줘"
"나는 이런 사람이야" — 맥락 설정
- "중소기업 마케팅 담당자. SNS 광고 운영이 주 업무"
- "대학원에서 교육학 논문 쓰는 중. 통계 분석은 아직 초보"
- "프리랜서 디자이너. 브랜딩 작업 위주로 하고 있어"
"내 프로젝트 상태 기억해" — AI를 작업 노트로
- "카페 창업 준비 중: 상권 분석 완료, 인테리어 업체 3곳 비교 단계"
- "졸업 논문: 설문 200부 회수 완료, SPSS로 요인 분석 진행 중"
- "유튜브 채널 운영: 주 2회 업로드, 편집은 프리미어 프로, 구독자 3천 명대"
예상 못했던 부분이에요. 단순한 선호도 저장을 넘어서, 유저들이 AI를 프로젝트 노트북처럼 쓰고 있더라고요. 창업 준비 상황, 논문 진행 단계, 심지어 실패한 이유까지 저장해두는 거예요.
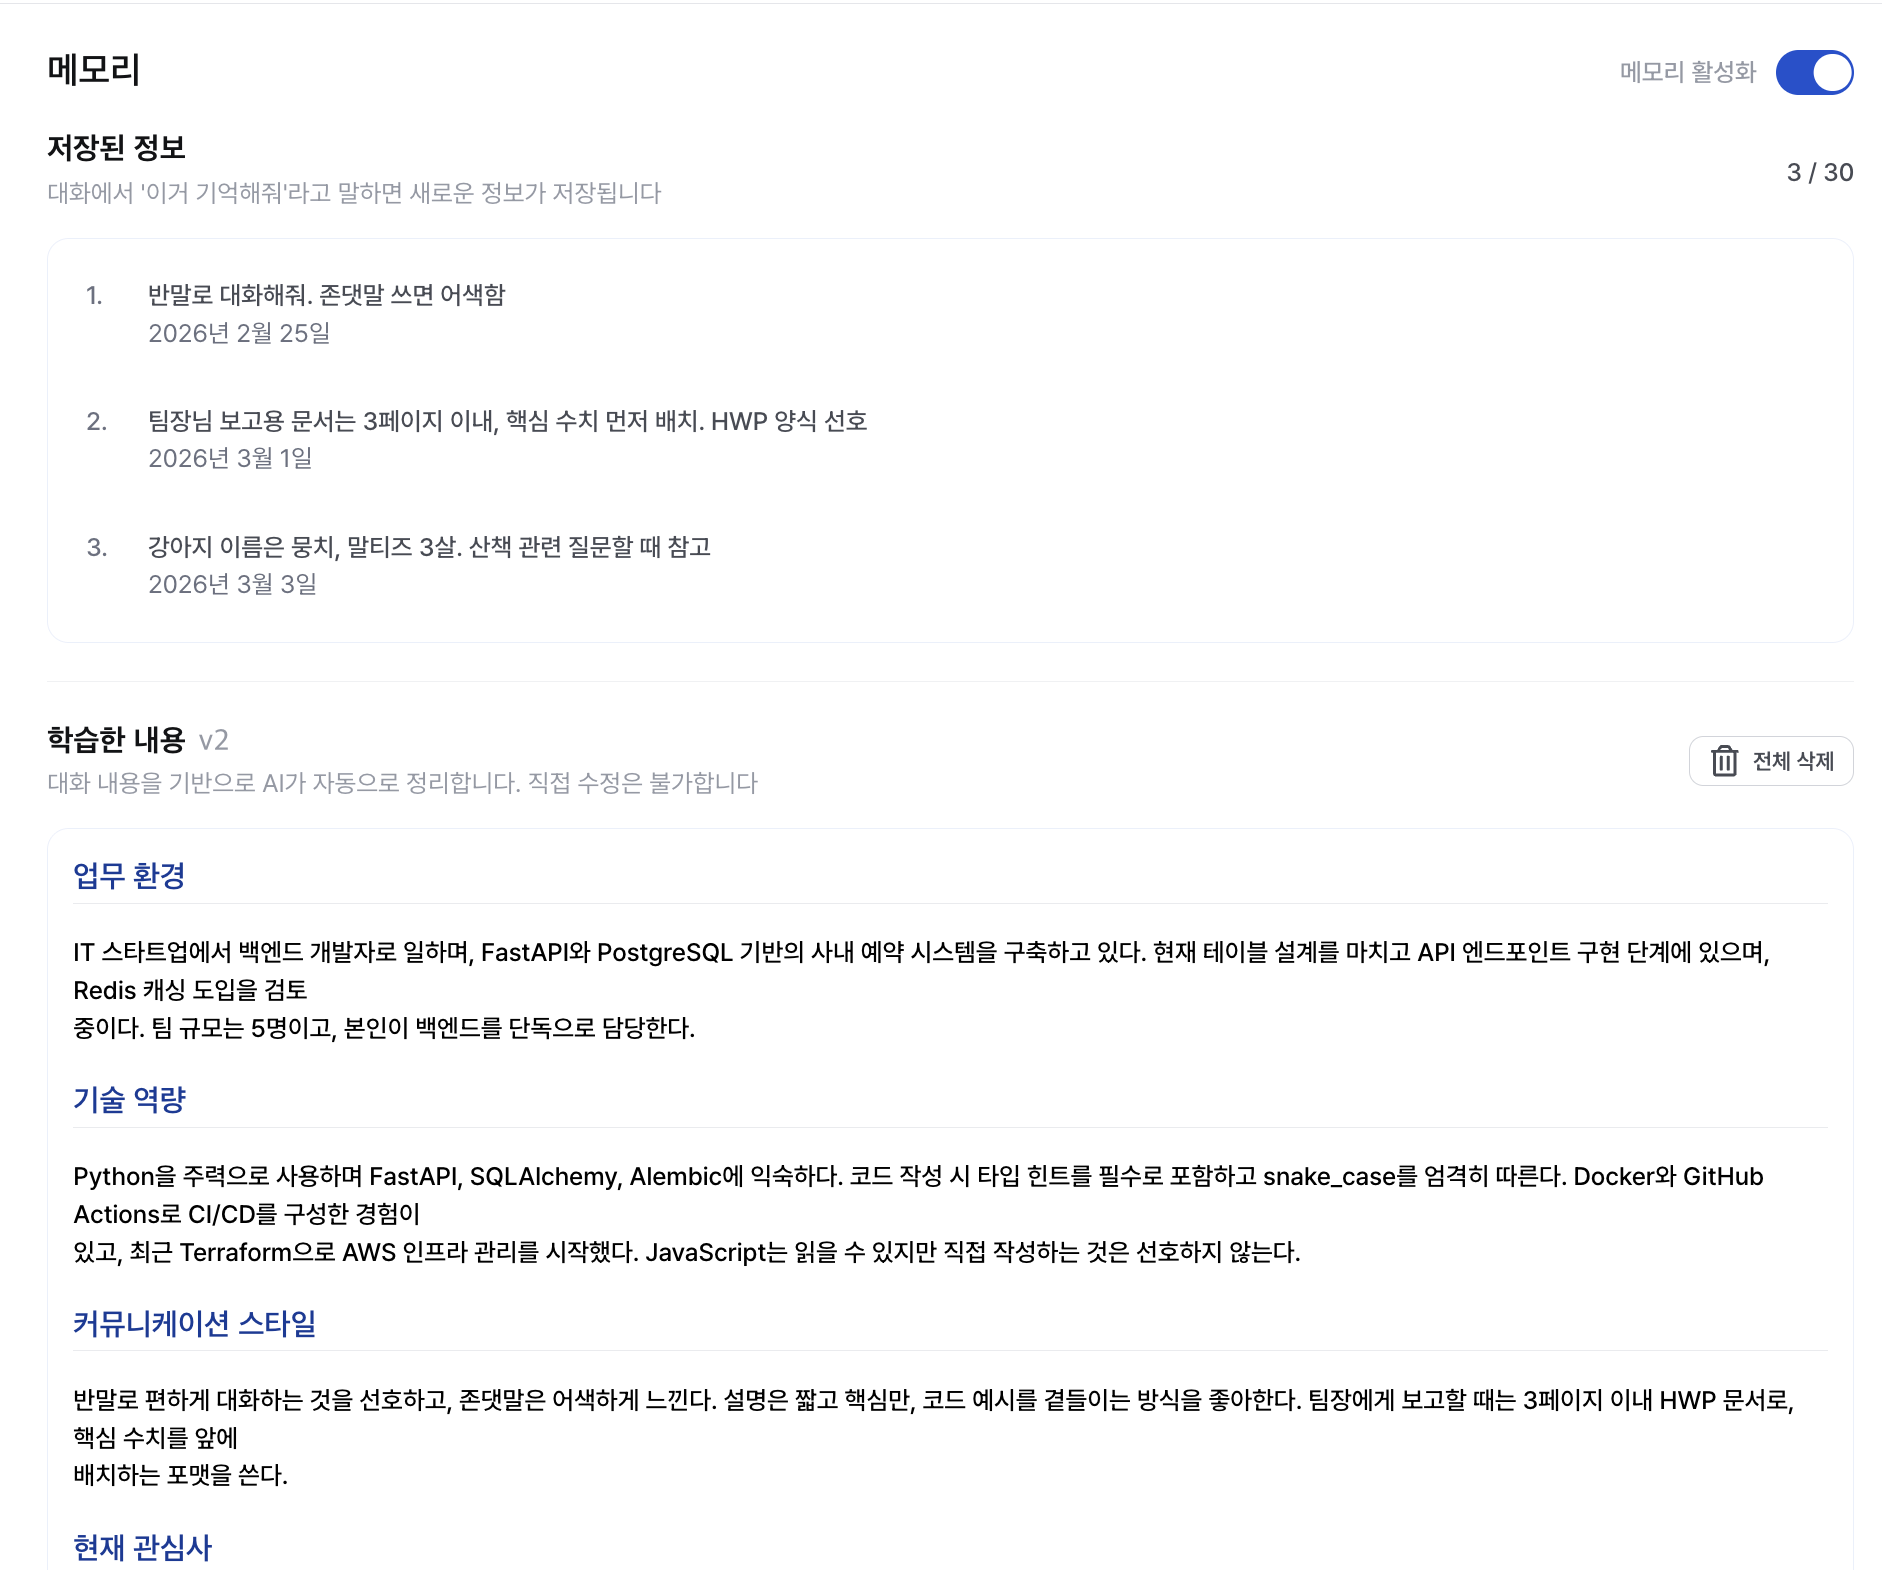
학습한 내용: AI가 자동으로 만드는 프로필
두 번째는 AI가 대화 내용을 분석해서 자동으로 생성하는 프로필이에요. 유저가 굳이 "나는 이런 사람이야"라고 말하지 않아도, 대화 속에서 자연스럽게 드러나는 정보들을 AI가 알아서 정리해 두는 거죠.
실제 프로필이 어떤 모습인지 예시를 들어볼게요. 어떤 영상 제작자의 프로필은 이런 식이에요:
업무 환경: 학기당 40편 이상의 교육 영상을 제작하는 멀티미디어 프로듀서. 브랜드 스토리텔링으로 전환 중. 촬영부터 컬러 그레이딩까지 전 과정을 직접 관리.
커뮤니케이션 스타일: 막연하거나 추상적인 조언을 거부하고, 구체적인 근거와 단계별 솔루션을 요구함. 노션에서 커스텀 스코어링 시스템으로 역량을 문서화하는 체계적 성향.
또 다른 예시로, 한 데이터 전문가의 프로필은:
기술 역량: Python 기반 Prophet, LSTM 시계열 예측 전문. 엔드투엔드 자동화 파이프라인 구축. 한국 주식 분석에 RSI, 볼린저 밴드 적용.
커뮤니케이션 스타일: 한국어로 소통하되 영어 기술 용어를 자연스럽게 혼용. 구조화되고 인용 근거가 있는 실행 가능한 답변을 선호 — 뜬구름 잡는 건 안 됨.
이름도, 소속도 없지만 — 이 사람이 어떤 사람인지, AI가 어떻게 대화해야 하는지가 명확하죠. 이게 AI Snapshot의 힘이에요.
프로필은 버전 관리도 돼요. 업데이트될 때마다 새 버전이 만들어지고, 최근 30개 버전까지 이력이 남아요. "어제의 프로필이 더 정확했는데?" 싶으면 확인할 수 있는 거죠.
두 저장소를 분리한 이유는 단순해요. 유저가 의도적으로 알려준 정보와 AI가 추론한 정보는 신뢰도가 다르잖아요. 저장된 정보가 항상 더 높은 우선순위를 가져요.
새벽 3시의 비밀
User Memory에서 가장 재밌는 부분이 여기예요. AI Snapshot은 실시간으로 만들어지는 게 아니에요. 매일 새벽 3시에 배치 작업으로 생성돼요.
왜 하필 새벽 3시?
트래픽이 가장 적은 시간이거든요. 새벽 2시에서 4시 사이가 가장 한산해요. 이 시간에 배치 작업을 돌리면 유저 경험에 영향을 주지 않으면서 서버 리소스도 넉넉하게 쓸 수 있어요.
어떻게 돌아가냐면요
AWS EventBridge가 매일 새벽 3시에 스케줄 이벤트를 발생시키고, Lambda를 거쳐 웹훅을 호출하면서 메모리 업데이트 작업이 시작돼요.
Step 1: 세션에서 컨텍스트 추출하기
각 유저의 최근 대화 세션들을 훑으면서, 유저에 대한 정보를 추출해요. 여기서 핵심이 하나 있는데요 — 이 추출 작업에 자체 LLM 모델인 SAIT 2 Pro를 사용해요. 외부 API를 호출하는 게 아니라 자체 모델로 처리하니까, 추론 비용이 사실상 0원이에요. 트래픽이 가장 낮은 새벽 시간대에 배치로 돌리니까 서버 리소스도 여유 있고요.
Step 2: 프로필로 병합하기
여러 세션에서 뽑아낸 정보들을 하나의 일관된 프로필로 합쳐요. 어제 대화에서 "마케팅팀"이라고 했고, 오늘 대화에서 "다음 주 캠페인 준비 중"이라고 했으면, 이 두 정보를 종합해서 프로필을 업데이트하는 거예요.
대규모 처리를 위한 설계
유저가 많아지면 배치 작업도 무거워지잖아요. 그래서 몇 가지 장치를 뒀어요.
한 번에 200명씩 묶어서 처리하고, 동시 실행 수를 세마포어로 100개까지 제한해요. 서버에 갑자기 부하가 몰리는 걸 방지하면서도 충분히 빠르게 처리할 수 있어요. 그리고 7일 이내에 활동이 있는 유저만 대상으로 해요. 한 달 넘게 접속하지 않은 유저의 메모리를 매일 갱신할 이유는 없으니까요.
메모리가 대화에 녹아드는 방법
메모리가 잘 저장돼 있다고 쳐요. 그러면 이걸 실제 대화에서 어떻게 쓸까요?
시스템 프롬프트에 유저 메모리를 주입해요. AI가 대화를 시작하기 전에 "이 사람에 대해 알고 있는 정보"를 미리 읽고 시작하는 거죠. 유저 한 명의 메모리는 약 1,200토큰 정도를 차지해요. 전체 컨텍스트 윈도우에 비하면 아주 작은 양인데, 대화 품질에 미치는 영향은 엄청 커요.
여기서 중요한 건 우선순위예요. 저장된 정보가 AI Snapshot보다 항상 우선해요. 유저가 직접 알려준 정보가 더 중요하다는 원칙을 끝까지 지키는 거죠.
프라이버시 — 기억할 권리와 잊힐 권리
가장 기본적인 원칙은 이거예요: 유저가 완전히 통제한다.
메모리 기능 자체를 켜고 끌 수 있어요. 토글 하나로요. 끄면 AI는 이전 대화에서 아무것도 기억하지 않아요. 기존에 쌓인 메모리도 대화에 반영되지 않고요.
본인의 메모리 데이터는 본인만 볼 수 있어요. 관리자도, 다른 멤버도 볼 수 없어요. "AI가 나에 대해 뭘 알고 있지?"라는 불안감이 없도록 투명하게 공개하되, 범위는 본인에게만 한정한 거예요.
대화하면서 기억을 관리하다
여기서 한 발 더 나갔어요. 설정 화면에서 수동으로 편집하는 것도 좋지만, 대화 중에 자연스럽게 메모리를 관리할 수 있으면 더 좋잖아요.
그래서 AI에게 memory_edit 도구를 줬어요. 대화 맥락에 따라 메모리를 추가하거나, 삭제하거나, 수정할 수 있어요.
유저가 "앞으로 답변은 영어로 해줘"라고 하면, AI가 알아서 메모리에 "선호 언어: 영어"를 추가해요. "아, 아까 말한 거 취소, 한국어가 좋아"라고 하면 기존 항목을 수정하고요. 마치 동료한테 "참고로 나 이번에 팀 옮겼어"라고 말하는 것처럼요.
물론 AI가 멋대로 기억을 저장하면 안 되니까, 민감한 정보는 저장하지 않도록 가이드라인을 설정해 뒀어요.
마무리
User Memory를 만들면서 가장 놀랐던 건, 유저들이 우리 예상보다 훨씬 깊은 정보를 AI에게 맡긴다는 거였어요. "커피 좋아해" 수준이 아니라, 프로젝트 진행 상황, 작업 환경 설정, 심지어 자기 커뮤니케이션 성향까지 세밀하게 저장해두는 거예요.
이건 단순한 기능이 아니라, AI와 사람 사이의 관계가 달라지는 거라고 생각해요.
결국 우리가 만들고 싶은 건, 오래 함께 일할수록 더 잘 맞게 되는 AI예요. 새 동료가 처음에는 어색하지만 시간이 지나면 눈빛만 봐도 통하는 것처럼요. User Memory는 그 여정의 첫걸음이에요.