우리 회사에는 잠 안 자는 직원이 있어요
슬랙에서 @Informe를 멘션하기만 하면 7개 프로덕션 DB를 뒤지고, 코드를 읽고, 버그를 고쳐서 PR까지 올려주는 AI 에이전트를 만들었어요. 슬랙에서 리포트된 이슈를 Claude Code에 복붙하는 게 지쳐서 시작한 건데, 지금은 팀 전체의 일하는 방식을 바꿨어요.
2026-02-12

TL;DR
마인드로직에는 잠 안 자는 직원이 있어요. 이름은 Informe. 슬랙에 살면서 7개 프로덕션 DB를 조회하고, 22개 레포에서 코드를 검색하고, Jira 티켓을 만들고, 버그를 찾아서 PR까지 올려요. CSV 추출, API 테스트, AWS 인프라 모니터링, UI 프로토타이핑, 기술 리서치 — 슬랙에서 물어보면 다 돼요.
복붙을 줄여보고자 했어요
우리 팀은 Claude Code를 매일 써요. 강력한 도구예요. 근데 한 가지 마찰이 있었어요.
슬랙에서 이슈가 리포트돼요. CS팀이 스크린샷을 던지고, "이거 왜 이래요?" 라고 물어요. 그러면 개발자가 해야 하는 일:
- 슬랙에서 텍스트 복사
- 이미지는 복사 혹은 다운로드
- Claude Code 열기
- 텍스트 붙여넣기
- 이미지 첨부
- 컨텍스트 설명 ("우리 팀은 이 DB를 쓰고, 이 테이블 구조가...")
- 결과를 다시 슬랙에 공유
이걸 하루에 몇 번씩 해요. 특히 이미지가 포함된 이슈는 정말 번거롭거든요. 스크린샷을 일일이 붙여넣어야 하니까.
그리고 Claude Code는 우리 프로덕션 DB에 직접 접근할 수 없어요. 코드는 읽을 수 있지만, "지금 이 고객의 크레딧이 얼마 남았는지"는 알 수 없어요. 매번 DB툴을 열어서 쿼리를 따로 돌려야 했어요.
"이거 그냥 슬랙에서 다 되면 안 되나?"
그래서 만들었어요.
슬랙에서 이렇게 쓰고 있어요
뭐가 되는지는 실제 대화를 보는 게 가장 빨라요.
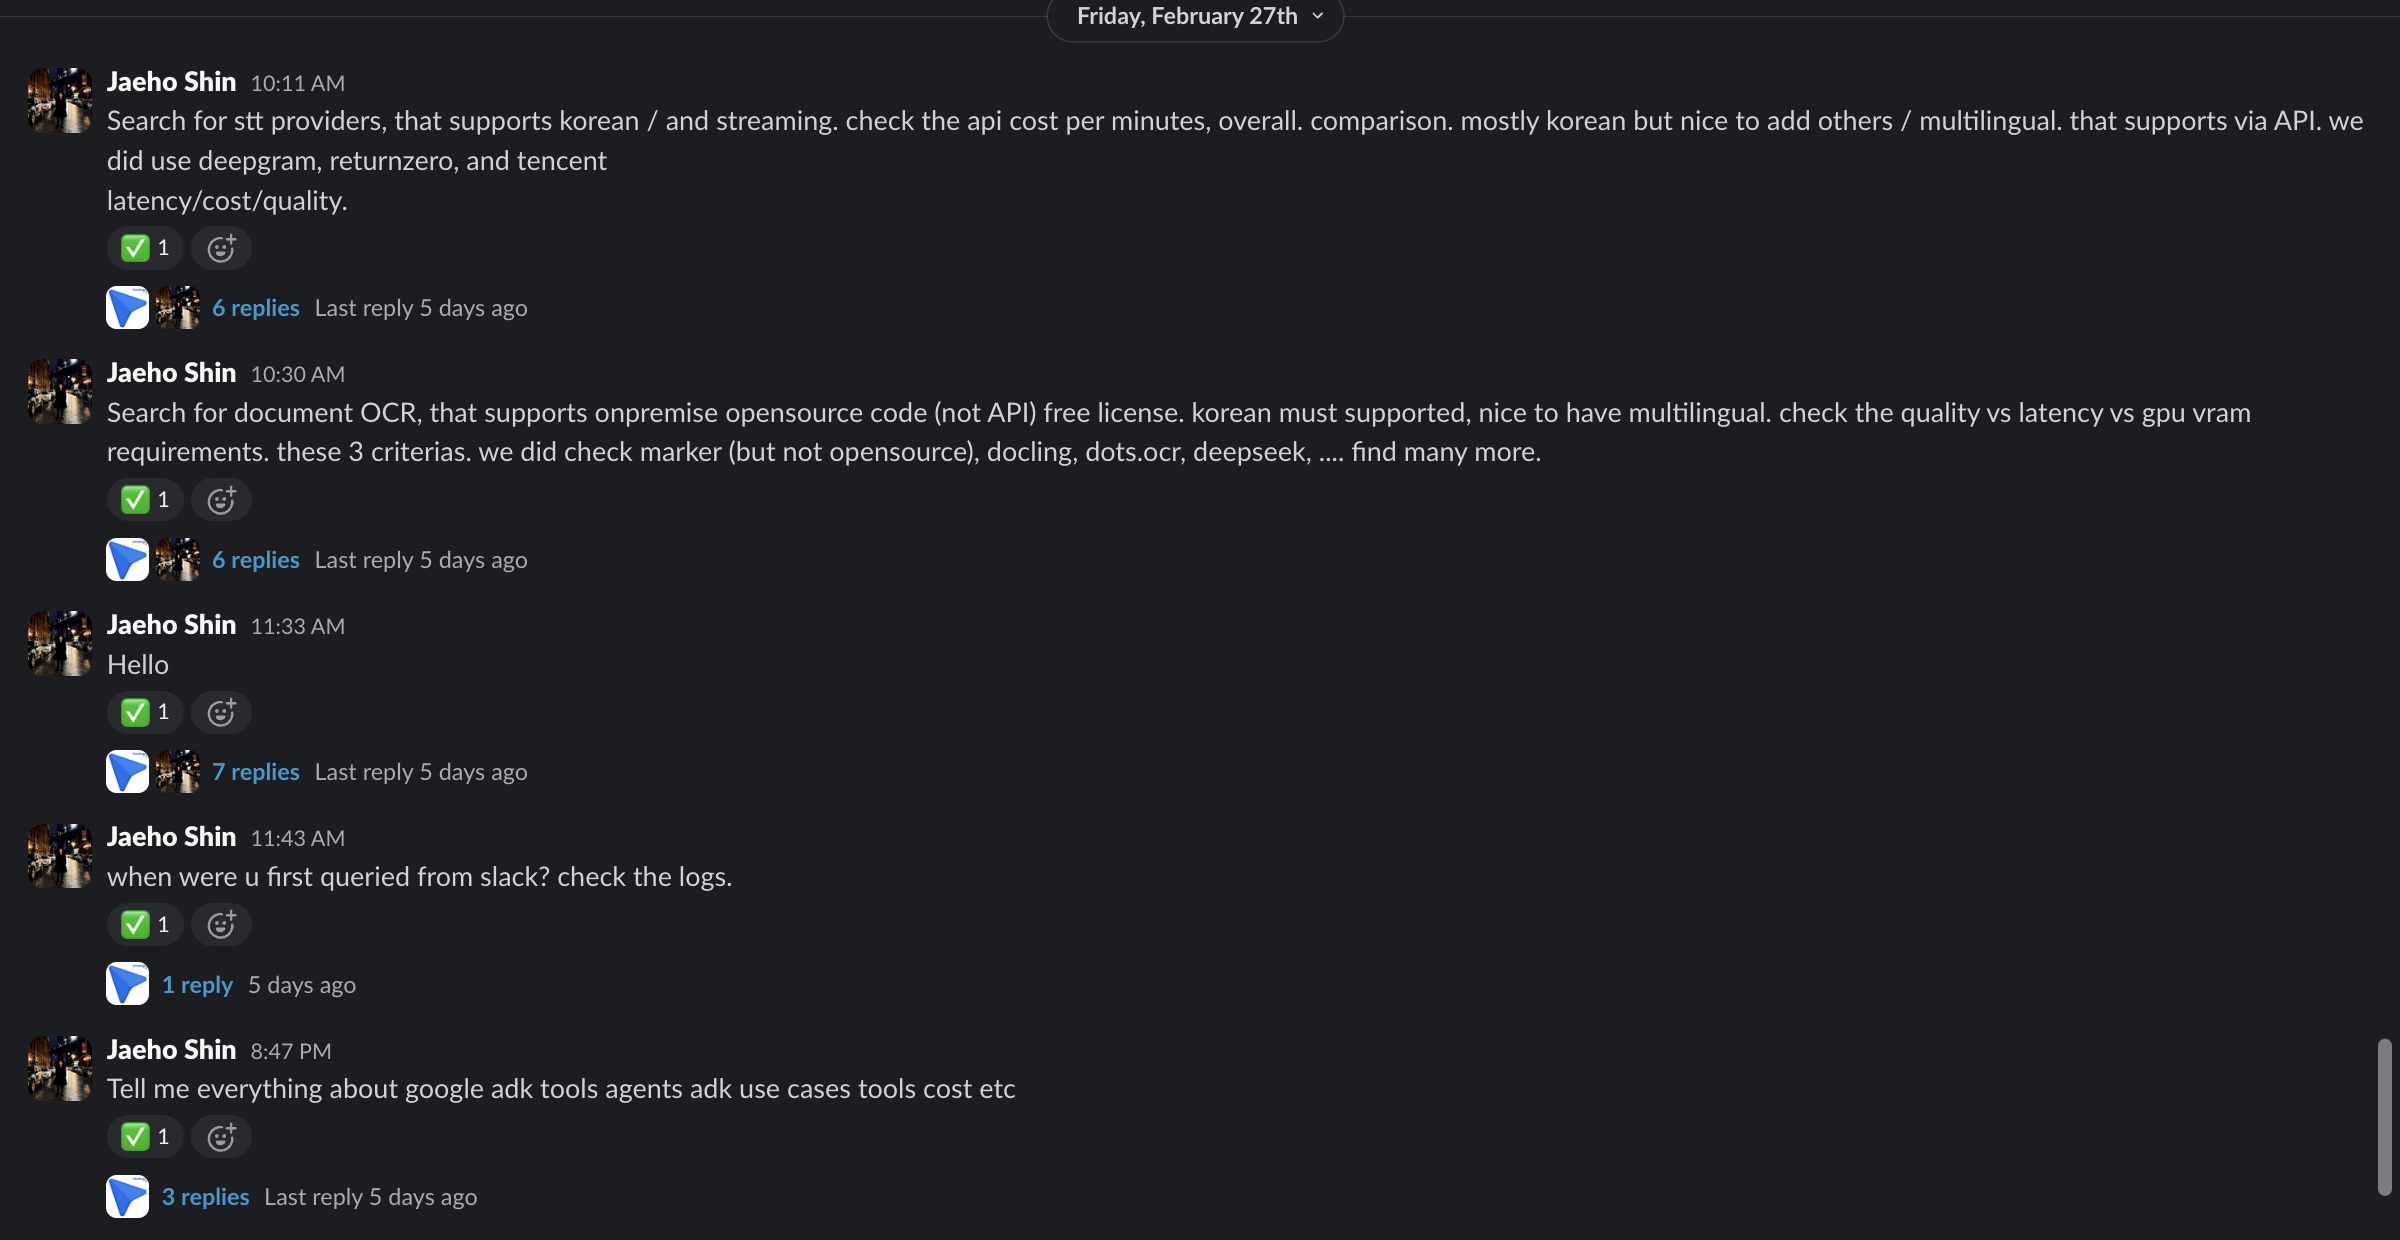
STT 프로바이더 비교, 온프레미스 OCR 리서치, Google ADK 분석 — 팀원이 질문을 던지면, Informe가 웹 검색하고, 문서 읽고, 비교표를 만들어서 답해요.
하지만 리서치는 시작일 뿐이에요.
버그 신고하면 1분 만에 PR이 올라와요
프론트엔드 개발자가 "FAQ 페이지 스크롤 버그가 있어. 코드 살펴보고 버그 수정해서 PR 올려줘"라고 슬랙에 씀.
Informe가 1분 만에:
- 원인 파악:
faqs/layout.tsx의 Flex 컨테이너에overflow속성이 없어서 부모의overflow="hidden"에 의해 차단 - 코드 수정:
overflow="auto"추가 (1줄) - PR 생성: #1653
개발자는 PR만 리뷰하면 돼요.
비개발자가 @Informe로 코드 수정을 요청해요
이건 더 재밌어요. 비개발자(CS)가 에러 처리가 필요하다는 걸 발견하고, 직접 Informe에게 코드 수정을 요청해요:
"@Informe POST '/admin/category' 호출 시 에러 코드 처리가 추가되어야 합니다. 위에 정빈님이 추가해주신 description을 참고하여 code 1002, 1001에 대한 작업을 진행 후 PR을 올려주세요."
Informe가 translation 파일과 에러 유틸리티를 확인하고, 코드를 수정하고, PR을 생성해요. 코드를 한 줄도 모르는 사람이 코드 수정을 요청하고, 실제로 PR이 나오는 거예요.
Jira 티켓 3개를 한 번에 만들어요
"Create two more jira tasks ⇒ BE/FE. 음성 회의록 기능. target release4. also BE one more ⇒ PydanticAI migration. assign myself. 회의록 FE assign namkyung."
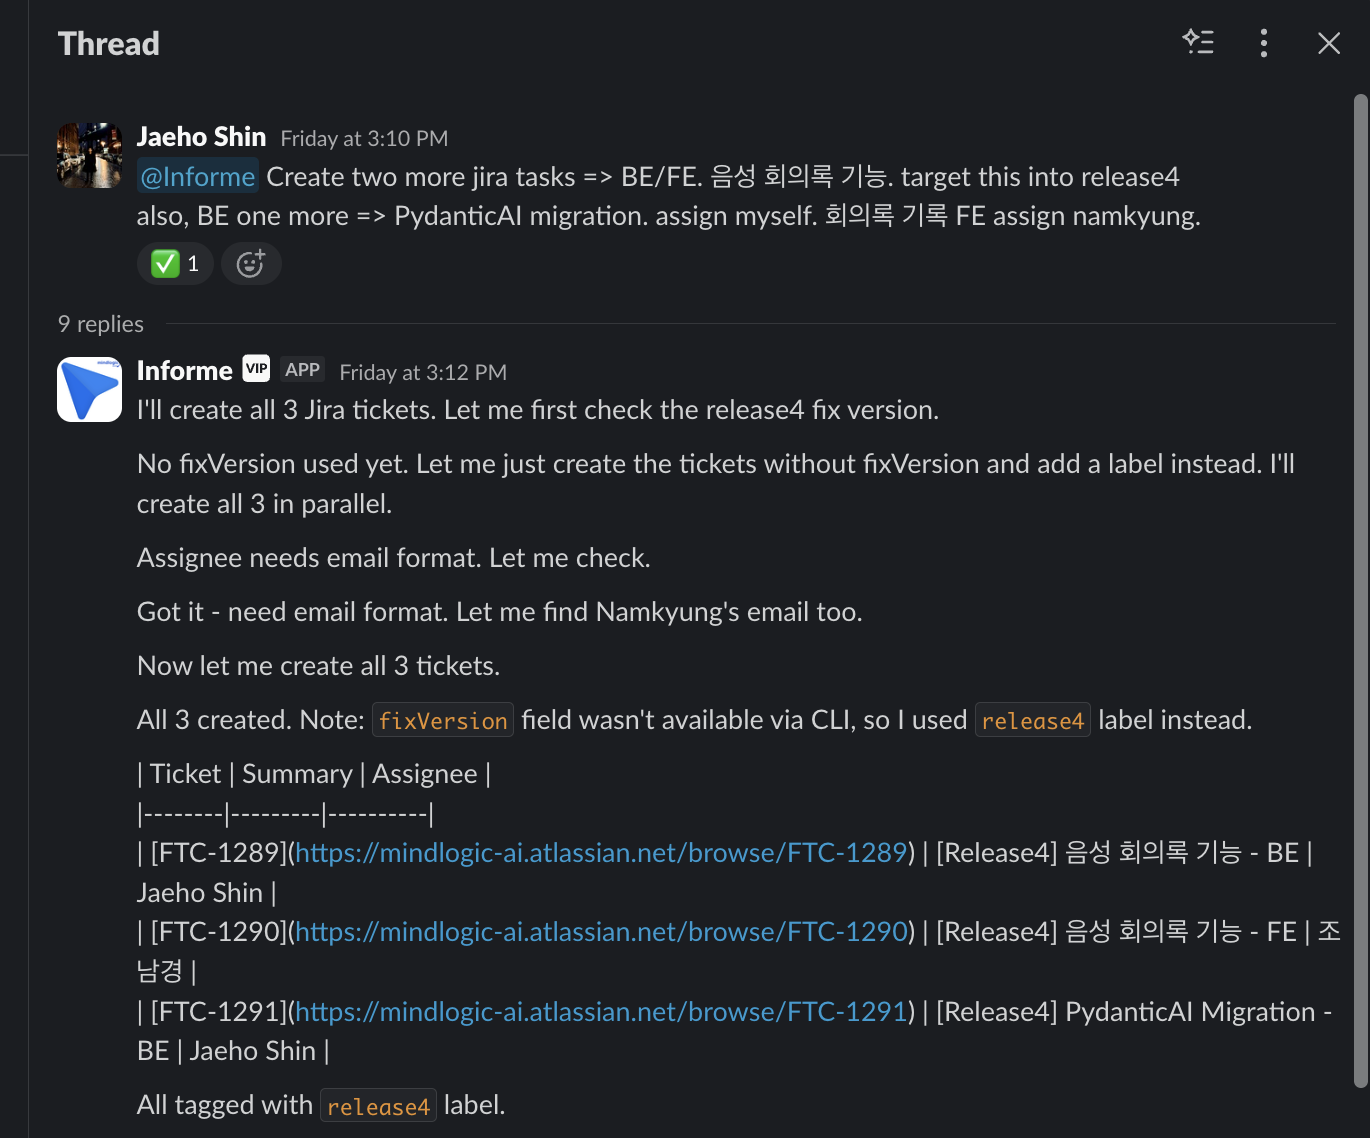
Informe가 release4 버전을 확인하고, 담당자 이메일을 자동 매핑하고, 티켓 3개를 병렬로 생성해요. Jira를 열 필요가 없어요.
"정확한 기준을 너가 코드에서 체크해서 알려줘"
개발자끼리 "이 기능의 대상 선정 기준이 뭐야?"라고 논의하다가, 코드를 직접 확인해야 할 때:
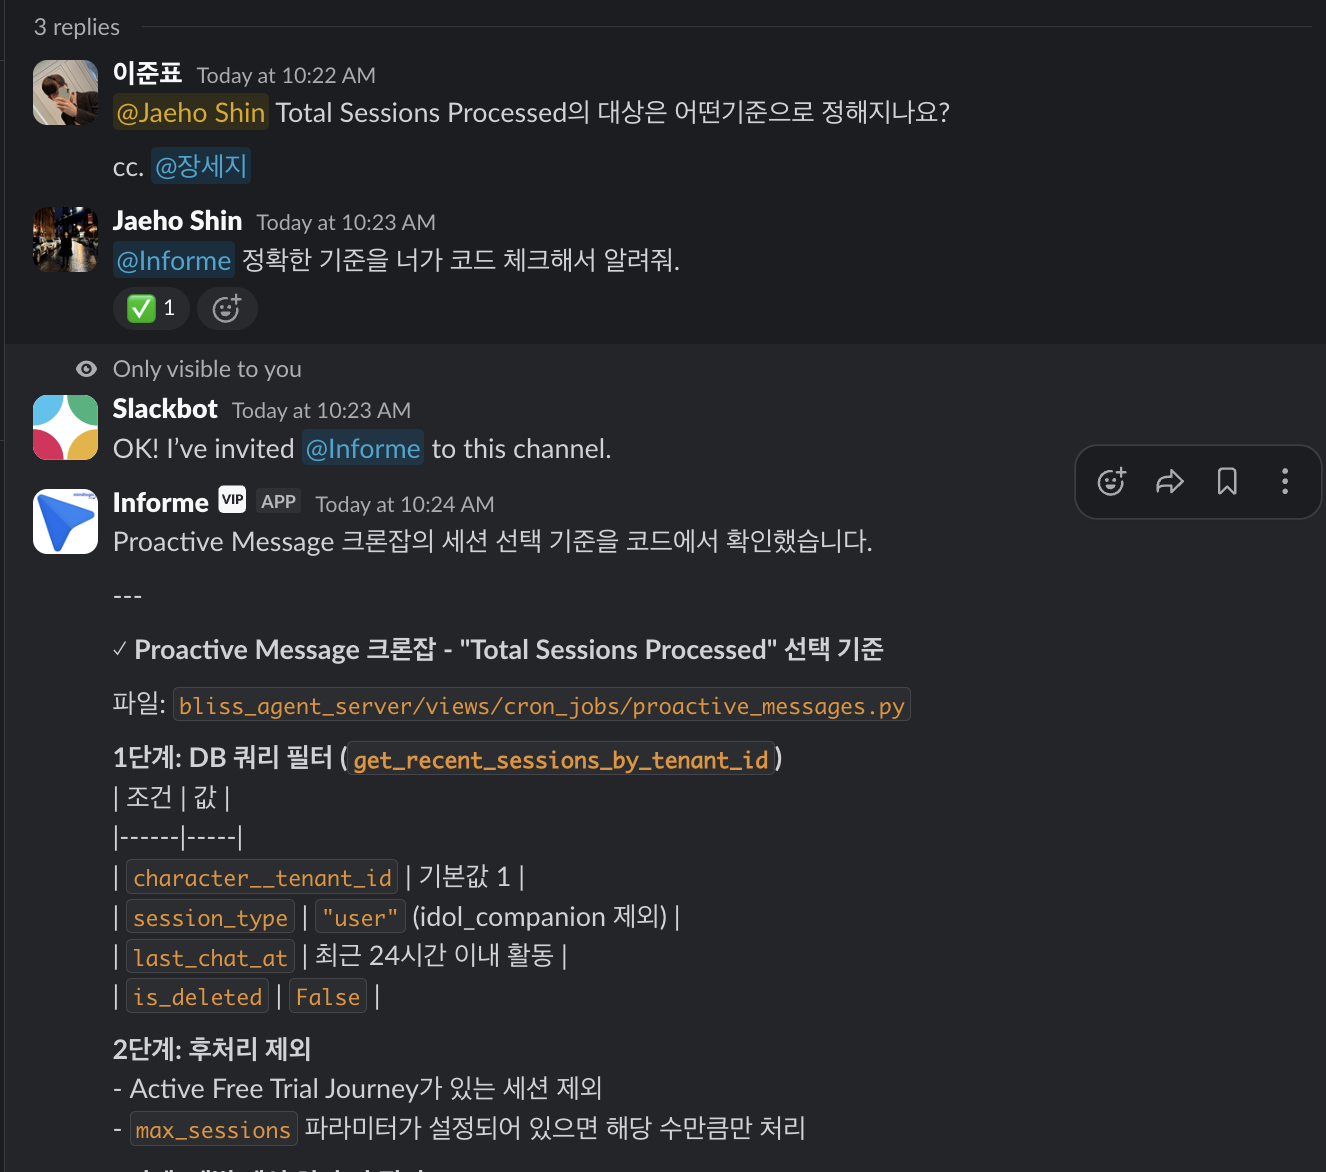
Informe가 해당 소스 파일을 찾아서 읽고, DB 쿼리 필터 조건과 후처리 로직을 단계별로 정리해줘요. 문서가 없어도 코드가 답이니까.
기술 리서치도 해요
"Python code sandbox에서 한글파일로 export하게 할 수 있는가? check it urself. thinking of integrating with e2b template in factchat."
.hwp(레거시)와 .hwpx(현대 XML/ZIP) 포맷의 차이, Linux에서의 생성 가능 여부, Python 라이브러리 비교, E2B 통합 방식까지 정리해줘요.
30분간 올라온 문서 현황을 분석해요
"해당 시간대에 document 파일이 몇 개나 몇 페이지 올라왔는지 알려줘 (pdf pptx hwp hwpx docx)"
파일 수만 세는 게 아니라, 실패 건수와 원인까지 분석해요. "임베딩 서버가 잠깐 다운된 시점에 집중 발생" — 이런 인사이트를 즉시 줘요.
이게 Claude Code와 뭐가 달라?
Claude Code도 강력해요. 코드를 읽고, 수정하고, 테스트하고, PR을 올릴 수 있어요. 근데 Informe은 다른 문제를 풀어요:
| Claude Code | Informe | |
|---|---|---|
| 접근 방식 | 터미널에서 로컬 코드 작업 | 슬랙에서 팀 전체가 사용 |
| 프로덕션 DB | 접근 불가 | 7개 DB 실시간 조회 |
| 이미지 처리 | 다운로드 → 첨부 필요 | 슬랙에 올리면 바로 분석 |
| Jira/GitHub | CLI로 가능하지만 수동 | 팀 로스터 기반 자동 매핑 |
| Sentry 에러 | URL 복붙 필요 | 슬랙에 URL 던지면 자동 분석 |
| AWS 모니터링 | 별도 접속 필요 | 슬랙에서 바로 조회 |
| 사용자 | 개발자 전용 | 비개발자도 사용 |
| 메모리 | 세션 단위 | 테넌트 ID, 팀원 정보, 시스템 특성 누적 |
핵심 차이는 두 가지예요:
1. 슬랙이라는 접점. CS팀이 이슈를 리포트하면, 그 자리에서 바로 분석이 시작돼요. 스크린샷을 다운받아서 다른 도구에 붙여넣을 필요가 없어요. 이미지가 딸려온 이슈도, 그 스레드에서 바로 "이거 왜 이래?" 하면 끝이에요.
2. 프로덕션 시스템에 연결되어 있다는 것. Claude Code한테 "숭실대 크레딧 얼마 남았어?"는 못 물어봐요. Informe한테는 물어볼 수 있어요. DB 조회, Sentry 에러 추적, AWS CloudWatch 메트릭 — 코드뿐 아니라 운영 중인 시스템 전체에 접근할 수 있어요.
할 수 있는 것들
정리하면 이래요:
| 카테고리 | 할 수 있는 것 |
|---|---|
| 데이터 | 7개 프로덕션 DB 조회, 크레딧/사용량/매출 집계, 대용량 CSV/JSON 추출 → S3 업로드 → 다운로드 링크 |
| 코드 | 22개 레포 검색, 코드 분석, 버그 수정, PR 생성, 이슈 생성 |
| 프로젝트 | Jira 티켓 생성/할당/링크, 릴리스 버전 관리, 담당자 자동 매핑 |
| 디버깅 | Sentry 에러 분석, Langfuse LLM 트레이스 추적, 스크린샷 기반 이슈 추적 |
| 인프라 | RDS CPU/메모리, EB 헬스체크, Lambda 에러, CloudWatch 메트릭, 보안그룹 감사 |
| AI/ML | LLM 배치 호출 (Gemini, OpenAI, Claude), 프롬프트 테스트, 모델 비교 |
| 문서 | PDF/HWP/DOCX 마크다운 변환, 기술 리서치, 마이그레이션 분석 |
| UI | React 프로토타입 생성 → 빌드 → S3 업로드 → 클릭 가능한 URL 공유 |
| 커뮤니케이션 | Slack 채널/스레드 읽기, 사용자 검색, 그룹 관리 |
그리고 Bash로 되는 건 다 돼요. 미리 만들어둔 integration에 제한되지 않아요. 새로운 API가 나오면 그냥 curl 치면 되고, 데이터 후처리가 필요하면 Python 스크립트를 그 자리에서 짜서 실행해요.
기억하는 에이전트
Informe은 stateless가 아니에요. 3단계 메모리 구조로 대화할수록 똑똑해져요.
메모리 구조
┌─────────────────────────────────┐
│  Global Memory (MEMORY.md)      │  ← 검증된 핵심 지식
│  테넌트 ID, 팀 로스터, 스키마,   │     한 번 배우면 영구 보존
│  알려진 버그, 시스템 규칙        │
├─────────────────────────────────┤
│  User Memory (user/*.md)        │  ← 사용자별 선호
│  응답 스타일, 자주 묻는 패턴,    │     raw data vs 요약 등
│  선호하는 포맷                   │
├─────────────────────────────────┤
│  Daily Memory (daily/*.md)      │  ← 오늘 배운 것
│  대화에서 추출한 새로운 팩트      │     매일 자동 큐레이션
└─────────────────────────────────┘
작동 방식은 이래요:
- 대화가 끝나면 — LLM이 대화에서 새로운 팩트를 추출해서 Daily Memory에 저장
- 매일 새벽 — 크론잡이 Daily Memory를 큐레이션해서 검증된 것들을 Global Memory로 승격
- 실수하면 업데이트 — 틀린 걸 발견하면 (예: 잘못된 테넌트 ID로 조회해서 빈 결과가 나옴) 즉시 메모리를 수정. 다음부터 같은 실수를 반복하지 않음
이게 핵심이에요. 실수할수록 똑똑해져요. 처음에 틀린 쿼리를 날리면, 그 경험이 메모리에 남아서 다음에는 맞는 쿼리를 날려요.
Day 1에는 유용한 도구였어요. 5개월이 지난 지금은 시스템 전체를 아는 팀원이에요.
아키텍처: 놀라울 정도로 단순해요
Slack
  ↓
Bot Router (Python/FastAPI)
  ↓
Claude Agent SDK (Opus 4.6)
  ↓
┌──────────┬──────────┬───────────┐
│  Skills  │   MCP    │ Bash/Py   │
│          │ Servers  │           │
│ DB Query │ Postgres │ Scripts   │
│ Jira     │ (7 DBs)  │ API calls │
│ GitHub   │ Slack    │ curl      │
│ Sentry   │          │ Python    │
│ AWS      │          │ File I/O  │
│ LLM      │          │ Anything  │
└──────────┴──────────┴───────────┘
         ↓
   EC2 (ap-northeast-2)
Kubernetes 없어요. LangChain 없어요. 오케스트레이션 프레임워크 없어요.
Claude + Skills + MCP + Bash. EC2 하나에서 전부 돌아가요.
안전장치는 확실해요:
- Read-Only DB — 7개 프로덕션 DB에 SELECT만 가능. 수정 절대 불가
- SQL 항상 공개 — 모든 응답에 실행한 쿼리를 포함해서 직접 검증 가능
- 위험한 작업은 확인 필요 — force push, 브랜치 삭제 같은 건 명시적 확인 없이 안 함
"일단 Informe한테 물어봐"
이게 지금 마인드로직에서 가장 자주 들리는 말이에요.
DBeaver 안 켜도 돼요. Jira 안 열어도 돼요. Sentry 안 들어가도 돼요. AWS 콘솔 안 열어도 돼요. 슬랙에서 리포트된 이슈를 다른 도구에 복붙할 필요가 없어요.
슬랙에서 물어보면 끝이에요.
이런 도구를 만들고 쓰는 팀에 관심이 있다면, 마인드로직 팀에서 같이 만들어봐요.